سؤال المشروع: عندما يستطيع الذكاء الاصطناعي بناء تطبيق أو نظام خلال وقت قصير، هل يعني ذلك أن المشروع آمن؟ ليس بالضرورة. هذا المقال يستعرض المشكلة، ثم يقدم مثالًا عمليًا على استخدام Security Review لفحص المشاريع التي تُبنى بمساعدة الذكاء الاصطناعي.
المشكلة ليست أن الذكاء الاصطناعي يكتب كودًا خاطئًا
أصبح بإمكاننا اليوم بناء تطبيقات ومواقع وأنظمة برمجية بمساعدة الذكاء الاصطناعي، وفي بعض الحالات يستطيع الوكيل البرمجي إنشاء الملفات وكتابة الكود وربط قاعدة البيانات وتشغيل الاختبارات وتنفيذ تعديلات متتابعة.
لكن نجاح المشروع في العمل لا يعني بالضرورة أنه آمن.
قد يعمل التطبيق بصورة طبيعية، وتبدو واجهته ممتازة، وتنجح وظائفه الأساسية، ومع ذلك يحتوي على مسار يسمح بتجاوز الصلاحيات، أو الوصول إلى بيانات غير مصرح بها، أو تنفيذ أوامر غير متوقعة، أو كشف أسرار ومفاتيح داخل المشروع.
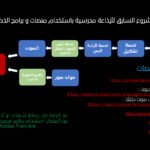
AI Generation
بناء المشروع بسرعة
بناء المشروع بسرعة
→
Security Review
فحص ما يمكن استغلاله
فحص ما يمكن استغلاله
→
Fix & Re-test
الإصلاح ثم إعادة الاختبار
الإصلاح ثم إعادة الاختبار
لماذا نحتاج Security Review؟
الفارق المهم هو بين عبارة «الكود يعمل» وعبارة «الكود آمن ضد مسارات الاستغلال المتوقعة». المراجعة الأمنية تضيف طبقة مستقلة تبحث عن نقاط الضعف بدل الاكتفاء باختبار الوظائف.
مثال بسيط: قد يحتوي التطبيق على صفحة تعرض بيانات المستخدم بشكل صحيح عند تسجيل الدخول. اختبار الوظائف سيؤكد أن الصفحة تعمل، لكن المراجعة الأمنية تسأل سؤالًا مختلفًا: هل يستطيع مستخدم عادي تغيير رقم المعرّف في الرابط والوصول إلى بيانات مستخدم آخر؟ هنا ننتقل من اختبار «هل الوظيفة تعمل؟» إلى اختبار «هل يمكن إساءة استخدامها؟».
مشروع Security Review
من المشاريع المفتوحة المصدر التي تعكس هذا الاتجاه Skill باسم security-review ضمن مستودع Claude Skills على GitHub. الفكرة هي إعطاء الوكيل منهجية منظمة لمراجعة التغييرات والكشف عن مشكلات أمنية محتملة، ثم محاولة التحقق منها قبل إدراجها في التقرير.
ما المقصود بـ Skill هنا؟ هي مجموعة تعليمات ومنهجية عمل تُضاف إلى الوكيل لكي تساعده على تنفيذ مهمة متخصصة بطريقة أكثر تنظيمًا. وفي هذا المثال، المهمة ليست كتابة كود جديد، بل مراجعة الكود الموجود من زاوية أمنية.
وهذا مهم لأن الأداة لا تجعل المشروع «آمنًا تلقائيًا»؛ هي تساعد في اكتشاف المخاطر والتحقق منها، بينما يبقى القرار النهائي والإصلاح والاختبار مسؤولية فريق التطوير.
مشاهدة مشروع security-review على GitHub ↗
الفيديو المرتبط بفكرة المقال
الفكرة الأساسية
لا يكفي أن يقول الوكيل: «قد توجد ثغرة». الأفضل أن يتتبع مسار البيانات، ويفهم السياق، ويحاول إثبات أن المشكلة قابلة للاستغلال، ثم يرفع النتائج التي تستحق اهتمام المطور.
كيف تتم المراجعة؟
1. اكتشاف المسارات الخطرة
يبحث الوكيل عن تدفقات قد تربط مدخلات غير موثوقة بنقاط حساسة، مثل قواعد البيانات أو أوامر النظام أو الملفات أو صلاحيات المستخدم.
ما معنى «مدخلات غير موثوقة»؟ هي أي بيانات لا ينبغي افتراض أنها آمنة لمجرد وصولها إلى التطبيق، مثل ما يكتبه المستخدم في نموذج، أو قيمة موجودة في عنوان URL، أو ملف يرفعه، أو بيانات تأتي من خدمة خارجية.
وما المقصود بـ «Sensitive Sink»؟ هو المكان الذي قد يؤدي وصول البيانات إليه بطريقة غير آمنة إلى نتيجة خطرة، مثل تنفيذ استعلام SQL، أو تشغيل أمر على الخادم، أو فتح ملف، أو إجراء طلب إلى عنوان داخلي. لذلك لا تنظر المراجعة إلى السطر وحده، بل تتبع رحلة البيانات من المصدر إلى النقطة الحساسة.
User Input → Validation → Application Logic → Sensitive Sink
بمعنى أبسط: «ماذا أدخل المستخدم؟ أين ذهبت هذه البيانات؟ وهل وصلت في النهاية إلى مكان يمكن أن تسبب فيه ضررًا؟».
2. محاولة إثبات المشكلة
بدل جمع تحذيرات كثيرة، تركز المنهجية على التحقق من النتائج. فإذا لم يكن هناك مسار واقعي للاستغلال، فلا ينبغي التعامل مع كل ملاحظة على أنها ثغرة مؤكدة.
لماذا التحقق مهم؟ لأن أداة التحليل قد ترى دالة خطرة وتفترض أنها قابلة للاستغلال، بينما قد يكون هناك في جزء آخر من التطبيق تحقق أو صلاحيات أو حماية تمنع الاستغلال فعليًا. لذلك الأفضل أن يتتبع الفحص المسار كاملًا قبل رفع النتيجة على أنها ثغرة.
ما أنواع المخاطر التي نبحث عنها؟
هذه المصطلحات قد تبدو تقنية، لكن فكرتها الأساسية بسيطة: كل واحدة منها تصف طريقة يمكن أن يُستخدم بها التطبيق بطريقة لم يقصدها المطور.
- SQL Injection: إدخال بيانات يتسبب في تغيير الاستعلام المرسل إلى قاعدة البيانات، وقد يسمح بقراءة أو تعديل بيانات غير مصرح بها.
- Command Injection: عندما تصل بيانات المستخدم إلى أمر نظام بطريقة تسمح بإضافة أو تنفيذ أوامر لم يقصدها التطبيق.
- Path Traversal: التلاعب بمسار ملف للوصول إلى ملفات خارج المجلد الذي يفترض أن يسمح التطبيق بالوصول إليه.
- تجاوز المصادقة والصلاحيات: الوصول إلى وظيفة أو بيانات دون إثبات الهوية أو دون امتلاك الصلاحية المطلوبة. المصادقة تجيب: من أنت؟ والصلاحيات تجيب: ماذا يُسمح لك أن تفعل؟
- Privilege Escalation: حصول مستخدم أو عملية على مستوى صلاحيات أعلى مما ينبغي، مثل انتقال حساب عادي إلى صلاحيات مدير.
- تسريب المفاتيح والأسرار: ظهور كلمات المرور أو مفاتيح API أو رموز الوصول داخل الكود أو الملفات أو السجلات، بما قد يسمح باستخدام خدمات أو حسابات دون تصريح.
- Remote Code Execution (RCE): تمكن طرف خارجي من جعل الخادم ينفذ تعليمات برمجية من اختياره، وهي من المخاطر شديدة الخطورة عندما تكون قابلة للاستغلال فعليًا.
- XSS: إدخال محتوى خبيث يظهر داخل صفحة ويب ويُنفذ في متصفح مستخدم آخر، إذا لم تتم معالجة المحتوى وإخراجه بأمان.
- SSRF: استغلال الخادم لإرسال طلبات إلى وجهات لم يكن من المفترض أن يصل إليها المستخدم مباشرة، وقد تصبح المشكلة أخطر إذا أمكن الوصول إلى خدمات داخلية.
- تسريب البيانات الحساسة: كشف معلومات مثل بيانات العملاء أو الرموز السرية أو السجلات الداخلية بسبب خطأ في التصميم أو الإعداد أو التحكم في الوصول.
من الكود إلى دورة تطوير أكثر أمانًا
عند بناء مشروع بالذكاء الاصطناعي، يمكن تحويل العملية من نموذج سريع:
Prompt → AI → Deployment
إلى دورة أكثر نضجًا:
Plan → Build with AI → Test → Security Review → Fix → Re-test → Deploy
لماذا هذه الخطوة مهمة في المشاريع التي ينشئها AI؟
لأن الوكيل البرمجي لا يكتب جزءًا واحدًا فقط. كلما ازدادت صلاحياته، قد يتعامل مع ملفات المشروع، وأوامر الطرفية، وقواعد البيانات، والشبكة، والخدمات الخارجية. لذلك تصبح المراجعة الأمنية جزءًا منطقيًا من دورة التطوير نفسها، وليس مرحلة إضافية بعد فوات الأوان.
والسبب الأهم أن سرعة توليد الكود قد تجعل من السهل إنشاء عدد كبير من الملفات والوظائف قبل أن يتوقف المطور لمراجعة الافتراضات الأمنية. وقد يقترح النموذج حلًا «يعمل» لكنه يستخدم إعدادًا افتراضيًا ضعيفًا، أو يضع مفتاح API في مكان غير مناسب، أو يطبق التحقق من الصلاحيات في بعض المسارات وينساه في مسار آخر.
الفكرة ليست أن الذكاء الاصطناعي «سيئ في البرمجة». المشكلة أن النموذج يمكنه توليد كود مقنع وصالح للتشغيل، بينما لا يعني ذلك أنه راجع كل سيناريوهات إساءة الاستخدام. لذلك نحتاج إلى فصل مرحلتي البناء والمراجعة الأمنية حتى لا يكون الكاتب هو الحكم الوحيد على عمله.
تنبيه مهم عند استخدام Skills وPlugins
هناك طبقة أخرى تستحق الانتباه: الأدوات نفسها. فالـSkill أو Plugin الذي نمنحه للوكيل قد يحتوي على تعليمات أو Scripts أو صلاحيات واسعة. لذلك ينبغي التعامل مع الأدوات الخارجية بحذر، وقراءة ما تفعله فعليًا قبل منحها صلاحيات داخل بيئة العمل.
لماذا؟ لأن الخطر لا يأتي فقط من الكود الذي يكتبه الوكيل، بل أيضًا من الأشياء التي نسمح للوكيل باستخدامها. فإذا كانت أداة ما قادرة على قراءة ملفات المشروع أو تشغيل أوامر أو الاتصال بخدمات خارجية، فإن أي سلوك غير آمن فيها قد يؤثر في البيئة التي تعمل داخلها.
مثال مبسط: إذا أضفت Skill لمهمة تبدو بسيطة مثل «تحليل المشروع»، فلا تفترض تلقائيًا أنها تملك صلاحية القراءة فقط. راجع التعليمات والـScripts والعمليات التي تنفذها، واسأل: ما الملفات التي يمكنها قراءتها؟ هل تستطيع تشغيل أوامر؟ هل ترسل بيانات إلى خدمة خارجية؟ وما الصلاحيات التي تعمل بها؟
توضح إرشادات Claude الرسمية أهمية فحص الـSkills والـPlugins الخارجية قبل استخدامها، كما أن مجتمع أدوات الوكلاء بدأ يشهد مشاريع مخصصة لتدقيق Skills نفسها.
إرشادات Claude حول فحص Skills وPlugins ↗
قاعدة عملية:
لا تعتبر المشروع آمنًا لمجرد أنه يعمل، ولا تعتبر أداة المراجعة آمنة لمجرد أن اسمها Security. افهم ما الذي تستطيع الأداة قراءته وتشغيله والوصول إليه قبل منحها الثقة.
لا تعتبر المشروع آمنًا لمجرد أنه يعمل، ولا تعتبر أداة المراجعة آمنة لمجرد أن اسمها Security. افهم ما الذي تستطيع الأداة قراءته وتشغيله والوصول إليه قبل منحها الثقة.
قائمة فحص سريعة قبل إطلاق مشروع بناه AI
إذا كنت تستخدم الذكاء الاصطناعي لبناء مشروع حقيقي، فهذه قائمة عملية مختصرة يمكن الرجوع إليها قبل النشر:
- اختبر المصادقة والصلاحيات: جرّب ما يحدث عندما يحاول مستخدم عادي الوصول إلى وظيفة مخصصة للمدير.
- راجع المدخلات: افحص البيانات القادمة من النماذج وURL والملفات والخدمات الخارجية، ولا تفترض أنها آمنة.
- ابحث عن الأسرار: تأكد من عدم وجود مفاتيح API أو كلمات مرور أو رموز وصول داخل الكود أو المستودع.
- راجع العمليات الحساسة: خصوصًا استعلامات قواعد البيانات، أوامر النظام، التعامل مع الملفات، والطلبات الشبكية.
- افحص الاعتماديات والإضافات: لا تكتفِ بمراجعة كودك؛ انتبه أيضًا للمكتبات والأدوات والـSkills والـPlugins التي أضفتها.
- نفّذ Security Review: اجعل المراجعة خطوة مستقلة بعد البناء، وليس مجرد سؤال للذكاء الاصطناعي «هل الكود آمن؟».
- أصلح ثم أعد الاختبار: اكتشاف المشكلة ليس نهاية العملية؛ يجب التأكد بعد الإصلاح من أن الثغرة أغلقت ولم تظهر مشكلة جانبية.
الخلاصة
الذكاء الاصطناعي جعل بناء المشاريع أسرع بكثير، لكن السرعة في البناء لا تعني السرعة في الوصول إلى مشروع آمن.
مشاريع مثل security-review تقدم مثالًا على اتجاه مهم: استخدام الوكلاء ليس فقط للبرمجة، وإنما أيضًا لمراجعة التغييرات والكشف عن مسارات الاستغلال المحتملة والتحقق منها قبل إطلاق المشروع.
وعند بناء أي مشروع بمساعدة الذكاء الاصطناعي، من المفيد أن يصبح السؤال جزءًا ثابتًا من العملية:
«ماذا يمكن أن يحدث لو حاول شخص ما إساءة استخدام هذا المشروع؟»
كلما طرحنا هذا السؤال مبكرًا، زادت فرصة اكتشاف المشكلة قبل أن تصبح حادثة أمنية.
روابط المشروع والمصادر: Security Review على GitHub · Claude: Skill & Plugin Scanning